はじめに
前回の記事では、ニューラルネットワークの順伝播について、2つの入力から中間層の2つのニューロンを計算し、最終的な出力を求めました。しかし、実際のニューラルネットワークには、数百個、数千個、あるいはそれ以上のニューロンが含まれることがあります。
そのすべてについて、重み付き和とバイアスの計算を1つずつ書き出すのは大変です。では、多数のニューロンの計算を、どのようにまとめて表せばよいのでしょうか。
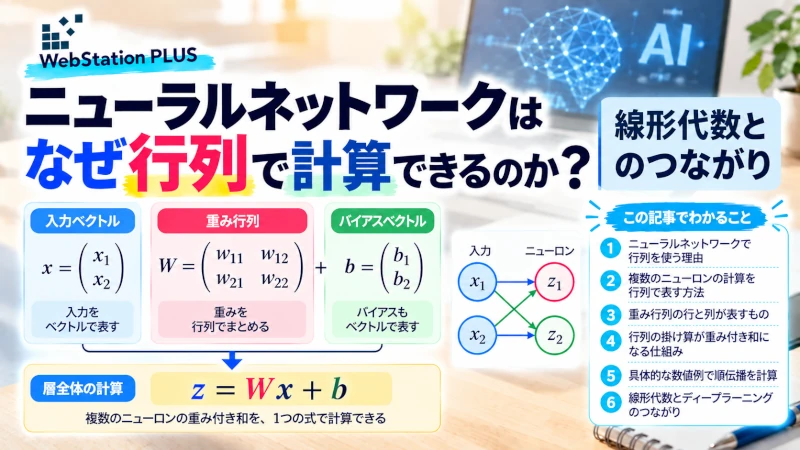
そこで役立つのが、線形代数で学ぶベクトルと行列です。実は、1つの層にある複数のニューロンの計算は、行列とベクトルの掛け算でまとめて表せます。
ニューラルネットワークの各層では、入力をベクトル、重みを行列、バイアスをベクトルとしてまとめることで、複数のニューロンの計算を1つの式で表せます。
この記事では、前回と同じ数値例を使い、ニューロンごとの計算が行列の計算に変わる仕組みを確認していきます。
この記事でわかること
この記事では、次の内容の理解を目指します。
- ニューラルネットワークで行列を使う理由
- 複数のニューロンの計算をベクトルと行列で表す方法
- 重み行列の行と列が何を表しているのか
- 行列の掛け算が重み付き和の計算になる理由
- 順伝播全体を行列で表す方法
- ニューロンが増えても同じ式で計算できる理由
1.なぜニューラルネットワークで行列を使うのか?
ニューラルネットワークの各ニューロンでは、入力に重みを掛け、その結果を足し合わせ、バイアスを加えます。さらに、必要に応じて活性化関数を適用し、次の層へ渡す値を求めます。
たとえば、2つの入力 \(x_1,\ x_2\) を受け取るニューロンでは、活性化関数を適用する前の値を次のように計算します。
$$
z=w_1x_1+w_2x_2+b
$$
ここで、\(w_1,\ w_2\) は重み、\(b\) はバイアスです。入力が増えれば重みも増えますが、基本となる計算は変わりません。
一方、1つの層に複数のニューロンがある場合は、それぞれが同じ入力を受け取り、異なる重みとバイアスを使って計算します。
たとえば、2つの入力と2つのニューロンがある場合、計算は次のようになります。
$$
\begin{aligned}
z_1&=w_{11}x_1+w_{12}x_2+b_1\\
z_2&=w_{21}x_1+w_{22}x_2+b_2
\end{aligned}
$$
この2つの式を見ると、どちらも「入力に重みを掛けて足し合わせ、バイアスを加える」という同じ形になっています。つまり、複数のニューロンは、同じ種類の計算を並行して行っているのです。この共通した計算をまとめて表すために、行列を使います。
2.複数のニューロンの計算を行列で表す
では、先ほどの2つの式を、ベクトルと行列を使って書き直してみましょう。
2.1.入力をベクトルにまとめる
まず、2つの入力 \(x_1,\ x_2\) を縦に並べ、1つのベクトルとして表します。
$$
\boldsymbol{x}=
\begin{pmatrix}
x_1\\
x_2
\end{pmatrix}
$$
このように、複数の数値をまとめたものがベクトルです。今回は、2つの成分を持つ列ベクトルを使います。
2.2.重みを行列にまとめる
次に、2つのニューロンが持つ重みを、次のように並べます。
$$
W=
\begin{pmatrix}
w_{11}&w_{12}\\
w_{21}&w_{22}
\end{pmatrix}
$$
この \(W\) を重み行列と呼びます。
重み行列では、各行が1つのニューロンに対応し、各列が1つの入力に対応します。たとえば、1行目の \(w_{11},\ w_{12}\) は1つ目のニューロンが使う重みで、2行目の \(w_{21},\ w_{22}\) は2つ目のニューロンが使う重みです。
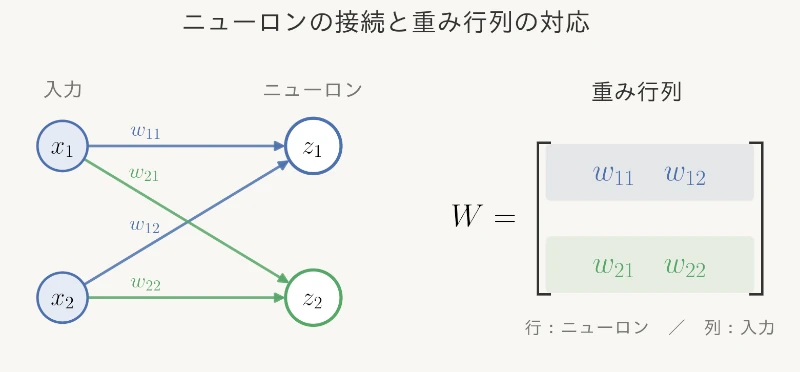
図では、入力 \(x_1,\ x_2\) から各ニューロンへ向かう4本の接続が、重み行列の4つの成分に対応しています。
2.3.バイアスと計算結果もベクトルにまとめる
バイアス \(b_1,\ b_2\) と、各ニューロンの計算結果 \(z_1,\ z_2\) も、それぞれベクトルにまとめます。
$$
\boldsymbol{b}=
\begin{pmatrix}
b_1\\
b_2
\end{pmatrix},
\qquad
\boldsymbol{z}=
\begin{pmatrix}
z_1\\
z_2
\end{pmatrix}
$$
これで、入力・重み・バイアス・計算結果を、すべてベクトルと行列で表せました。
3.行列の掛け算が重み付き和になる理由
ここからが、今回の記事で最も重要な部分です。
先ほど定義した重み行列 \(W\) と入力ベクトル \(\boldsymbol{x}\) を掛けると、次のようになります。
$$
\begin{aligned}
W\boldsymbol{x}
&=
\begin{pmatrix}
w_{11}&w_{12}\\
w_{21}&w_{22}
\end{pmatrix}
\begin{pmatrix}
x_1\\
x_2
\end{pmatrix}\\[6pt]
&=
\begin{pmatrix}
w_{11}x_1+w_{12}x_2\\
w_{21}x_1+w_{22}x_2
\end{pmatrix}
\end{aligned}
$$
行列とベクトルの掛け算では、行列の各行とベクトルの対応する成分を掛け、それらを足し合わせます。この結果を見ると、1行目は1つ目のニューロンの重み付き和、2行目は2つ目のニューロンの重み付き和になっています。
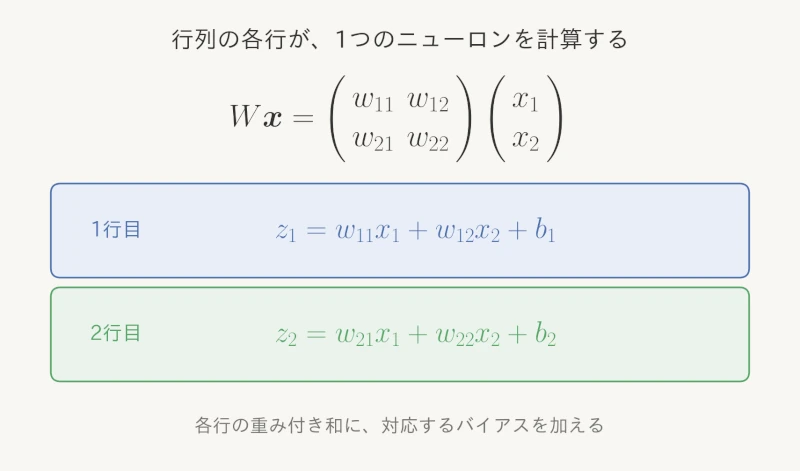
つまり、行列とベクトルの掛け算は、複数のニューロンの重み付き和をまとめて計算しているのです。
さらに、バイアスベクトルを加えると、次のようになります。
$$
\begin{aligned}
W\boldsymbol{x}+\boldsymbol{b}
&=
\begin{pmatrix}
w_{11}x_1+w_{12}x_2\\
w_{21}x_1+w_{22}x_2
\end{pmatrix}
+
\begin{pmatrix}
b_1\\
b_2
\end{pmatrix}\\[6pt]
&=
\begin{pmatrix}
w_{11}x_1+w_{12}x_2+b_1\\
w_{21}x_1+w_{22}x_2+b_2
\end{pmatrix}
\end{aligned}
$$
これは、最初に書いた2つのニューロンの計算式と同じです。
したがって、複数のニューロンの計算を、次の1つの式で表せます。
$$
\boldsymbol{z}=W\boldsymbol{x}+\boldsymbol{b}
$$
行列の各行が1つのニューロンの重みに対応するため、行列とベクトルの掛け算によって、層全体の重み付き和をまとめて計算できます。
なお、数学的には \(W\boldsymbol{x}\) は線形変換ですが、バイアスを加えた \(W\boldsymbol{x}+\boldsymbol{b}\) は一般にアフィン変換と呼ばれます。ニューラルネットワークでは、これらをまとめて線形層などと呼ぶこともあります。
4.前回の順伝播を行列で計算してみる
ここまでは、文字を使って計算を整理しました。続いて、前回の「順伝播」で扱った具体例を、行列で計算してみましょう。
今回も、2つの入力、2つの中間ニューロン、1つの出力ニューロンからなるネットワークを考えます。
4.1.入力ベクトルと中間層の重み行列
前回の入力は \(x_1=2,\ x_2=3\) でした。したがって、入力ベクトルは次のようになります。
$$
\boldsymbol{x}=
\begin{pmatrix}
2\\
3
\end{pmatrix}
$$
また、中間層の2つのニューロンでは、次の重みとバイアスを使いました。
$$
W^{(1)}=
\begin{pmatrix}
1&-1\\
-1&1
\end{pmatrix},
\qquad
\boldsymbol{b}^{(1)}=
\begin{pmatrix}
2\\
-2
\end{pmatrix}
$$
上付きの \((1)\) は、1番目の計算層である中間層を表します。また、重み行列の1行目が中間層の1つ目のニューロン、2行目が2つ目のニューロンに対応しています。
4.2.行列の掛け算で中間層を計算する
まず、重み行列と入力ベクトルを掛け、バイアスベクトルを加えます。
$$
\begin{aligned}
\boldsymbol{z}^{(1)}
&=W^{(1)}\boldsymbol{x}+\boldsymbol{b}^{(1)}\\[6pt]
&=
\begin{pmatrix}
1&-1\\
-1&1
\end{pmatrix}
\begin{pmatrix}
2\\
3
\end{pmatrix}
+
\begin{pmatrix}
2\\
-2
\end{pmatrix}\\[6pt]
&=
\begin{pmatrix}
2-3\\
-2+3
\end{pmatrix}
+
\begin{pmatrix}
2\\
-2
\end{pmatrix}\\[6pt]
&=
\begin{pmatrix}
1\\
-1
\end{pmatrix}
\end{aligned}
$$
これで、2つのニューロンについて、活性化関数を適用する前の値がまとめて求まりました。
続いて、各成分にReLU関数を適用します。ReLU関数は、正の値をそのまま残し、負の値を \(0\) に変換する関数です。
$$
\begin{aligned}
\boldsymbol{h}
&=f(\boldsymbol{z}^{(1)})\\
&=
\begin{pmatrix}
\max(0,\ 1)\\
\max(0,\ -1)
\end{pmatrix}\\[6pt]
&=
\begin{pmatrix}
1\\
0
\end{pmatrix}
\end{aligned}
$$
ここでは、\(f\) をベクトルに適用するとき、各成分に同じReLU関数を適用するものとします。こうして、中間層の出力 \(h_1=1,\ h_2=0\) が得られました。これは、前回ニューロンごとに計算した結果と一致しています。
4.3.出力層も行列で計算する
次に、中間層の出力を使って、出力層を計算します。
前回の出力層では、2つの重みと1つのバイアスを使いました。これらを行列とベクトルで表すと、次のようになります。
$$
W^{(2)}=
\begin{pmatrix}
2&-1
\end{pmatrix},
\qquad
\boldsymbol{b}^{(2)}=
\begin{pmatrix}
1
\end{pmatrix}
$$
出力層にはニューロンが1つしかないため、重み行列は1行2列です。中間層の出力 \(\boldsymbol{h}\) を入力として、次のように計算します。
$$
\begin{aligned}
\boldsymbol{z}^{(2)}
&=W^{(2)}\boldsymbol{h}+\boldsymbol{b}^{(2)}\\[6pt]
&=
\begin{pmatrix}
2&-1
\end{pmatrix}
\begin{pmatrix}
1\\
0
\end{pmatrix}
+
\begin{pmatrix}
1
\end{pmatrix}\\[6pt]
&=
\begin{pmatrix}
2\times1+(-1)\times0+1
\end{pmatrix}\\[6pt]
&=
\begin{pmatrix}
3
\end{pmatrix}
\end{aligned}
$$
最後にReLU関数を適用すると、出力は \(y=3\) になります。
$$
\boldsymbol{y}
=f(\boldsymbol{z}^{(2)})
=
\begin{pmatrix}
3
\end{pmatrix}
$$
今回は出力が1つなので、最終的な値をスカラーとして \(y=3\) と書くこともできます。
このように、前回ニューロンごとに計算した順伝播を、行列とベクトルを使って表しても、同じ結果が得られます。
5.順伝播全体を行列の式で表す
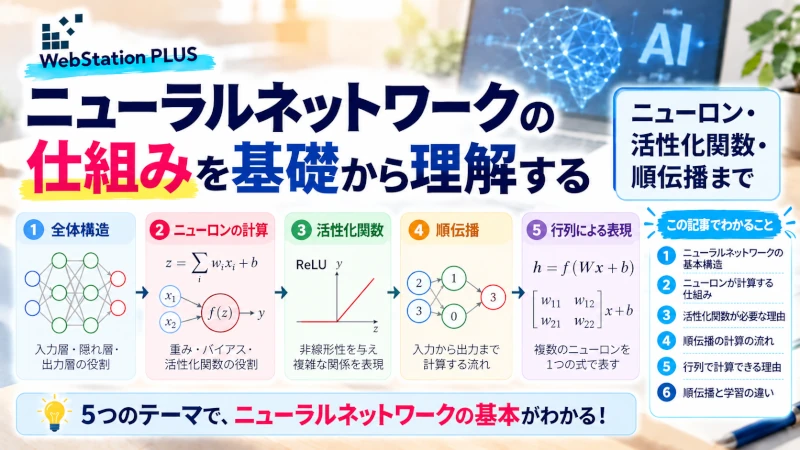
ここまで、中間層と出力層を別々に計算してきました。これらをまとめると、今回のニューラルネットワークの順伝播は、次の2つの式で表せます。
$$
\begin{aligned}
\boldsymbol{h}
&=f(W^{(1)}\boldsymbol{x}+\boldsymbol{b}^{(1)})\\[6pt]
\boldsymbol{y}
&=f(W^{(2)}\boldsymbol{h}+\boldsymbol{b}^{(2)})
\end{aligned}
$$
中間層では、入力ベクトルに重み行列を掛け、バイアスを加えてから活性化関数を適用します。そして、その出力ベクトルを次の層の入力として使います。
さらに、中間層の式を出力層の式へ代入すると、ネットワーク全体を次のように表すこともできます。
$$
\boldsymbol{y}
=
f\left(
W^{(2)}
f(W^{(1)}\boldsymbol{x}+\boldsymbol{b}^{(1)})
+\boldsymbol{b}^{(2)}
\right)
$$
式は少し長くなりましたが、行っていることは変わりません。前の層の出力に重み行列を掛け、バイアスを加え、活性化関数を適用する処理を繰り返しているだけです。
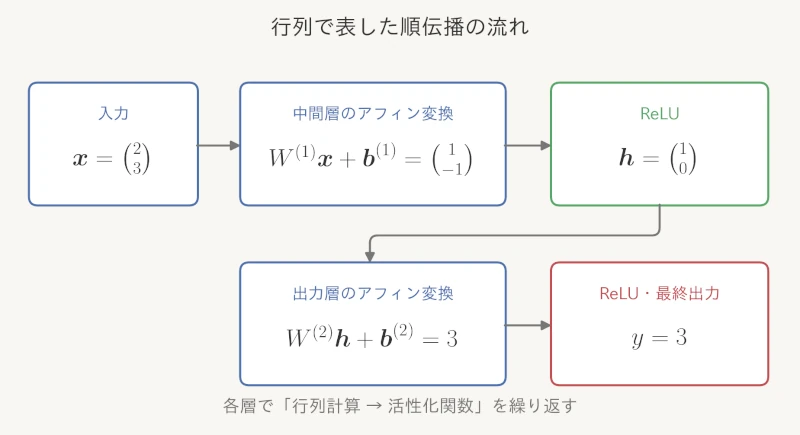
図のように、順伝播では各層で同じ形の計算を繰り返します。行列を使うことで、ニューロンごとの細かな計算を、層単位の処理として整理できるのです。
6.ニューロンが増えても同じ式で表せる
ここまでは、2つの入力と2つの中間ニューロンを使いました。しかし、入力やニューロンの数が増えても、基本となる式は変わりません。
たとえば、入力が3個、中間層のニューロンが4個ある場合を考えます。このとき、入力ベクトルは3つの成分を持ち、重み行列は4行3列、バイアスベクトルは4つの成分を持ちます。
$$
\boldsymbol{x}=
\begin{pmatrix}
x_1\\
x_2\\
x_3
\end{pmatrix},
\qquad
W=
\begin{pmatrix}
w_{11}&w_{12}&w_{13}\\
w_{21}&w_{22}&w_{23}\\
w_{31}&w_{32}&w_{33}\\
w_{41}&w_{42}&w_{43}
\end{pmatrix}
$$
$$
\boldsymbol{b}=
\begin{pmatrix}
b_1\\
b_2\\
b_3\\
b_4
\end{pmatrix}
$$
この場合も、計算は次の式で表せます。
$$
\boldsymbol{h}=f(W\boldsymbol{x}+\boldsymbol{b})
$$
行列の各行が1つのニューロンに対応しているため、4行3列の重み行列と3成分の入力ベクトルを掛けると、4成分のベクトルが得られます。
一般に、入力が \(n\) 個、出力側のニューロンが \(m\) 個ある層では、重み行列は \(m\) 行 \(n\) 列になります。
$$
\underbrace{W}_{m\times n}
\underbrace{\boldsymbol{x}}_{n\times1}
+
\underbrace{\boldsymbol{b}}_{m\times1}
=
\underbrace{\boldsymbol{z}}_{m\times1}
$$
このように、重み行列の行数は出力側のニューロン数、列数は入力の数に対応します。入力やニューロンの数が変わっても、行列の大きさを変えれば、同じ計算式を使えます。
7.行列で表すことにはどんなメリットがあるのか?
行列を使う最大のメリットは、多数のニューロンの計算を、共通した形で扱えることです。
たとえば、100個の入力から200個のニューロンへ値を渡す場合、重みは合計20,000個あります。これらをニューロンごとに別々の式で表す代わりに、200行100列の重み行列としてまとめられます。
また、行列の計算は、コンピューターで効率よく実行するための方法が広く整備されています。NumPyなどの数値計算ライブラリや、ディープラーニングのフレームワークでは、こうした行列演算を利用できます。
ただし、行列で書くだけで必ず計算が速くなるわけではありません。実際の速度は、計算するデータの大きさや、使用するライブラリ、CPU・GPUなどの実行環境にも左右されます。
重要なのは、行列を使うことで、複数のニューロンの計算を統一的に表せることです。さらに、複数の入力データをまとめて扱う場合にも、行列や、より一般的なテンソルの計算が役立ちます。
8.線形代数とニューラルネットワークのつながり
ここまでの内容を振り返ると、ニューラルネットワークの計算には、線形代数の考え方がそのまま使われていることがわかります。
入力をベクトルとして表し、重みを行列としてまとめ、行列とベクトルの掛け算によって重み付き和を計算します。そして、バイアスを加え、活性化関数を適用します。
ここで、前々回の記事で説明した「非線形性」との関係も確認しておきましょう。
重み行列を掛ける計算 \(W\boldsymbol{x}\) は線形変換であり、バイアスを加えた \(W\boldsymbol{x}+\boldsymbol{b}\) はアフィン変換です。これらだけを何層重ねても、全体は1つのアフィン変換としてまとめられます。
一方、ReLUなどの非線形な活性化関数を間に入れることで、単一のアフィン変換では表せない関係も表現できるようになります。
つまり、ニューラルネットワークでは、行列による重み付き和の計算と、活性化関数による非線形な変換を組み合わせているのです。
ニューラルネットワークの基本は、行列によるアフィン変換と、活性化関数による非線形変換を繰り返すことです。線形代数は、その計算を理解するための土台となります。
まとめ
今回、見てきたことをまとめます。
- 複数のニューロンは、それぞれ重み付き和とバイアスの計算を行っている
- 入力をベクトル、重みを行列、バイアスをベクトルとしてまとめられる
- 重み行列の各行は1つのニューロンに、各列は1つの入力に対応する
- 行列とベクトルの掛け算は、複数のニューロンの重み付き和をまとめて計算する
- 前回の順伝播を行列で計算しても、中間層の出力は1と0、最終出力は3になる
- 入力やニューロンの数が増えても、行列の大きさを変えれば同じ式で表せる
- ニューラルネットワークは、行列によるアフィン変換と非線形な活性化関数を組み合わせている
ニューラルネットワークの各層の計算は、次の式でまとめられます。
$$
\boldsymbol{h}=f(W\boldsymbol{x}+\boldsymbol{b})
$$
ニューラルネットワークが行列で計算できるのは、各ニューロンの重み付き和が、行列とベクトルの掛け算に対応しているからです。
今回は、前回の順伝播を行列で書き直すことで、線形代数とニューラルネットワークのつながりを確認しました。
これで、ニューラルネットワークの基本構造、ニューロンの計算、活性化関数、順伝播、行列による表現までを一通り学びました。
次のPhaseでは、ステップ関数・シグモイド関数・tanh関数・ReLU関数・ソフトマックス関数を取り上げ、それぞれの活性化関数がどのような計算を行い、どのような場面で使われるのかを詳しく見ていきます。
関連記事
(準備中)
シリーズ全体を理解する
(準備中)
Phase 1|ニューラルネットワークの基礎をまとめて理解する
関連書籍
ニューラルネットワークの仕組みをさらに理解したい方には、次の書籍もおすすめです。


コメント