はじめに
前回の記事では、シグモイド関数が入力を \(0\) から \(1\) の範囲に変換する仕組みを確認しました。
シグモイド関数は、入力に応じて滑らかに変化し、微分を使って勾配を計算できる活性化関数です。しかし、出力が常に正の値になることや、入力の絶対値が大きい領域では勾配が小さくなることなどの特徴もあります。
では、出力が \(0\) から \(1\) ではなく、\(-1\) から \(1\) の範囲になる関数を使ったらどうでしょうか。その代表的な活性化関数が、tanh関数(双曲線正接関数)です。
この記事では、tanh関数が入力を \(-1\) から \(1\) の範囲に変換する仕組みを理解し、シグモイド関数との違いがニューラルネットワークの計算や学習にどのような影響を与えるのかを考えます。
この記事でわかること
この記事では、次の内容の理解を目指します。
- tanh関数がどのような計算を行うのか
- シグモイド関数との数学的な関係
- 出力が \(0\) を中心とすることの意味
- ニューロンでtanh関数を使う計算例
- tanh関数の微分と勾配の関係
- tanh関数の特徴と限界
1.tanh関数とは何か?
tanh関数(hyperbolic tangent function)は、入力を \(-1\) から \(1\) の範囲に滑らかに変換するS字型の関数です。次の式で定義されます。
$$
\tanh(x)=\frac{e^x-e^{-x}}{e^x+e^{-x}}
$$
ここで、\(e\) は自然対数の底で、約 \(2.71828\) です。
この関数の特徴は、入力 \(x\) がどのような実数であっても、出力が次の範囲に収まることです。
$$
-1\lt\tanh(x)\lt1
$$
シグモイド関数が \(0\) から \(1\) の範囲に出力するのに対し、tanh関数は負の値も出力できます。
1.1.具体的な値を計算してみる
まず、入力が \(x=0\) の場合を考えます。
$$
\tanh(0)
=\frac{e^0-e^0}{e^0+e^0}
=0
$$
次に、入力が \(x=1\) の場合は、次のようになります。
$$
\tanh(1)
=\frac{e-e^{-1}}{e+e^{-1}}
\approx0.762
$$
一方、入力が \(x=-1\) の場合は、\(\tanh(-1)\approx-0.762\) となります。
このように、tanh関数は入力が正の場合には正の値、負の場合には負の値を出力し、入力が \(0\) のときには出力も \(0\) になります。
1.2.tanh関数のグラフ
tanh関数をグラフにすると、次のようになります。
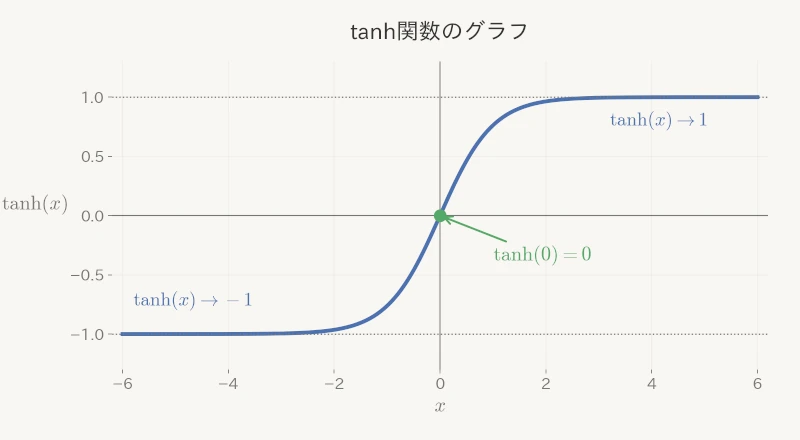
グラフを見ると、入力が \(x=0\) のとき出力は \(0\) になり、その周辺では入力の変化に応じて出力が大きく変化しています。
一方、入力が正の方向に大きくなると出力は \(1\) に、負の方向に小さくなると \(-1\) に近づきます。ただし、有限の入力では出力がちょうど \(1\) や \(-1\) になることはありません。
また、tanh関数には次の性質があります。
$$
\tanh(-x)=-\tanh(x)
$$
これは、グラフが原点を中心として対称になることを意味します。このような関数を奇関数と呼びます。
2.シグモイド関数とは何が違うのか?
tanh関数とシグモイド関数は、どちらも滑らかなS字型の関数です。しかし、出力の範囲と中心が異なります。まず、2つの関数を比較してみましょう。
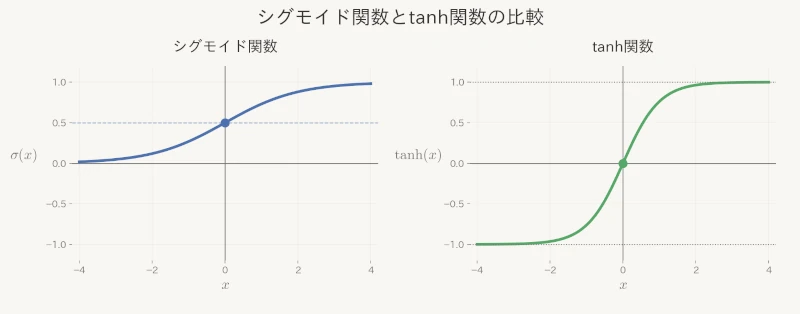
2つの関数は形が似ていますが、シグモイド関数は \(0\) から \(1\)、tanh関数は \(-1\) から \(1\) の範囲で変化します。
| 特徴 | シグモイド関数 | tanh関数 |
|---|---|---|
| 出力範囲 | \(0\) から \(1\) | \(-1\) から \(1\) |
| 入力が \(0\) のとき | \(0.5\) | \(0\) |
| 負の出力 | 出力しない | 出力する |
| グラフの対称性 | \((0, 0.5)\) を中心とする点対称 | 原点対称 |
tanh関数は、シグモイド関数の出力を単純に上下へ移動しただけの関数ではありません。出力の範囲だけでなく、入力に対する変化の大きさも異なります。
2.1.tanh関数とシグモイド関数の数学的な関係
実は、tanh関数はシグモイド関数を使って表すことができます。シグモイド関数は、次の式で定義されます。
$$
\sigma(x)=\frac{1}{1+e^{-x}}
$$
ここで、入力を \(2x\) に置き換えると、\(\sigma(2x)=\frac{1}{1+e^{-2x}}\) となります。
この式を使って \(2\sigma(2x)-1\) を計算すると、次のようになります。
$$
\begin{aligned}
2\sigma(2x)-1
&=\frac{2}{1+e^{-2x}}-1\\
&=\frac{1-e^{-2x}}{1+e^{-2x}}\\
&=\frac{e^x-e^{-x}}{e^x+e^{-x}}\\
&=\tanh(x)
\end{aligned}
$$
したがって、次の関係が成り立ちます。
$$
\tanh(x)=2\sigma(2x)-1
$$
つまり、tanh関数は、シグモイド関数の入力を2倍にし、出力を2倍してから \(1\) を引いた関数です。この関係から、tanh関数とシグモイド関数のグラフが似ている理由もわかります。
2.2.出力が \(0\) を中心とするとはどういうことか?
シグモイド関数は、入力が負の場合でも正の値を出力します。一方、tanh関数は入力の符号に応じて、正の値と負の値を出力できます。
たとえば、入力が \(x=-1,\ 0,\ 1\) の場合を比較します。
| 入力 | シグモイド関数 | tanh関数 |
|---|---|---|
| \(-1\) | 約 \(0.269\) | 約 \(-0.762\) |
| \(0\) | \(0.5\) | \(0\) |
| \(1\) | 約 \(0.731\) | 約 \(0.762\) |
このように、シグモイド関数の出力は \(0.5\) を中心として変化するのに対し、tanh関数の出力は \(0\) を中心として変化します。特に、tanh関数では入力が \(0\) を境に正負へ変化すると、出力も正負へ変化します。
この性質をゼロ中心(zero-centered)の出力と呼びます。ただし、ゼロ中心とは、どのような入力データに対しても出力の平均が必ず \(0\) になるという意味ではありません。tanh関数の形が原点対称であり、正負の出力を持つことを表しています。
3.tanh関数はニューロンでどのように使われるのか?
では、tanh関数をニューロンに組み込むと、どのような計算になるのでしょうか。前回と同じように、2つの入力を受け取るニューロンを考えます。
入力を \(x_1,\ x_2\)、重みを \(w_1,\ w_2\)、バイアスを \(b\) とすると、活性化関数を適用する前の値は次のようになります。
$$
z=w_1x_1+w_2x_2+b
$$
ここにtanh関数を適用すると、ニューロンの出力 \(y\) は次のようになります。
$$
y=\tanh(z)
$$
シグモイド関数では、重み付き和とバイアスの計算結果を \(0\) から \(1\) の範囲に変換しました。一方、tanh関数では、\(-1\) から \(1\) の範囲に変換します。
3.1.具体例で計算してみる
前回のシグモイド関数の記事と同じ条件で比較してみましょう。重みとバイアスを次のように設定します。
$$
w_1=1,\quad w_2=1,\quad b=-3
$$
このとき、ニューロンの計算は \(z=x_1+x_2-3\) となります。
まず、入力が \(x_1=2,\ x_2=2\) の場合を計算します。
$$
\begin{aligned}
z&=2+2-3=1\\
y&=\tanh(1)\approx0.762
\end{aligned}
$$
一方、入力が \(x_1=1,\ x_2=1\) の場合は、次のようになります。
$$
\begin{aligned}
z&=1+1-3=-1\\
y&=\tanh(-1)\approx-0.762
\end{aligned}
$$
前回のシグモイド関数では、同じ入力に対して約 \(0.731\) と \(0.269\) を出力しました。一方、tanh関数では、入力に応じて正の値と負の値を出力できることがわかります。
4.tanh関数を微分するとどうなるのか?
ここからは、tanh関数を微分すると何がわかるのかを考えます。
前回の記事では、シグモイド関数の導関数が、シグモイド関数自身の出力を使って計算できることを確認しました。実は、tanh関数にも同じような性質があります。
4.1.tanh関数の導関数を求める
tanh関数は、次の式で定義されます。
$$
\tanh(x)=\frac{e^x-e^{-x}}{e^x+e^{-x}}
$$
分子と分母をそれぞれ次のように置きます。
$$
u=e^x-e^{-x},\quad v=e^x+e^{-x}
$$
これらを微分すると、\(u’=e^x+e^{-x}\)、\(v’=e^x-e^{-x}\) となります。
商の微分公式を使うと、次のようになります。
$$
\begin{aligned}
\tanh'(x)
&=\frac{u’v-uv’}{v^2}\\
&=\frac{(e^x+e^{-x})^2-(e^x-e^{-x})^2}
{(e^x+e^{-x})^2}\\
&=1-
\left(
\frac{e^x-e^{-x}}{e^x+e^{-x}}
\right)^2
\end{aligned}
$$
ここで、tanh関数の定義を使うと、次の関係が得られます。
$$
\tanh'(x)=1-\tanh^2(x)
$$
つまり、tanh関数の導関数も、tanh関数自身の出力を使って計算できるのです。
4.2.導関数の値を確認する
入力が \(x=0\) のとき、\(\tanh(0)=0\) なので、導関数は次のようになります。
$$
\tanh'(0)=1-0^2=1
$$
一方、入力が \(x=1\) のときは、\(\tanh(1)\approx0.762\) なので、次のようになります。
$$
\tanh'(1)
\approx1-0.762^2
\approx0.420
$$
同様に、\(x=-1\) のときも導関数の値は約 \(0.420\) です。このように、tanh関数の導関数は入力が \(0\) のときに最大値 \(1\) を取り、入力の絶対値が大きくなるほど小さくなります。
5.tanh関数は学習にどのような影響を与えるのか?
ここまで、tanh関数の出力と微分の特徴を確認しました。では、これらの特徴はニューラルネットワークの学習にどのような影響を与えるのでしょうか。
5.1.シグモイド関数との勾配の違い
前回の記事では、シグモイド関数の導関数が次のようになることを確認しました。
$$
\sigma'(x)=\sigma(x)(1-\sigma(x))
$$
この導関数の最大値は \(0.25\) です。一方、tanh関数の導関数は、
$$
\tanh'(x)=1-\tanh^2(x)
$$
であり、最大値は \(1\) です。2つの導関数をグラフで比較すると、次のようになります。
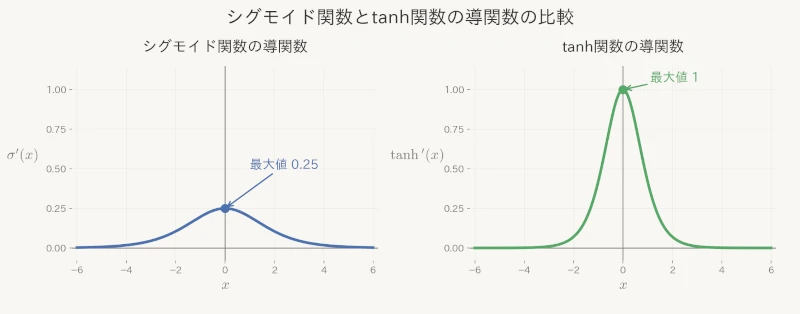
グラフから、入力が \(0\) の付近ではtanh関数の導関数がシグモイド関数より大きいことがわかります。
具体的に、入力が \(x=0\) の場合を比較すると、次のようになります。
$$
\begin{aligned}
\sigma'(0)&=0.25\\
\tanh'(0)&=1
\end{aligned}
$$
同じ入力 \(x=0\) に対して、tanh関数の導関数はシグモイド関数の4倍です。また、入力が \(x=1\) の場合は、次のようになります。
$$
\begin{aligned}
\sigma'(1)&\approx0.197\\
\tanh'(1)&\approx0.420
\end{aligned}
$$
これらの計算からも、tanh関数とシグモイド関数では、入力の変化に対する出力の変化率が異なることがわかります。ただし、導関数の最大値が大きいからといって、tanh関数を使ったネットワークの学習が必ず速くなるわけではありません。実際の勾配は、重み行列や損失関数などにも依存します。
5.2.出力が \(0\) を中心とすると、なぜ学習に有利な場合があるのか?
第2.2節では、tanh関数が正負の値を出力できることを確認しました。では、この性質はニューラルネットワークの学習にどのような影響を与えるのでしょうか。
あるニューロンの出力 \(a\) が、次の層のニューロンに入力される場合を考えます。次の層の重みを \(w\)、バイアスを \(b\) とすると、重み付き和は次のようになります。
$$
z=wa+b
$$
ここで、損失を \(L\) とすると、連鎖律を使って重みの勾配は次のように表せます。
$$
\frac{\partial L}{\partial w}
=
\frac{\partial L}{\partial z}
\frac{\partial z}{\partial w}
$$
\(\frac{\partial z}{\partial w}=a\) なので、次の関係が得られます。
$$
\frac{\partial L}{\partial w}
=
\frac{\partial L}{\partial z}a
$$
つまり、次の層の重みの勾配には、前の層から伝わる出力 \(a\) が直接関係しているのです。
ここで、説明を簡単にするために、2つの入力例で \(\frac{\partial L}{\partial z}=1\) だったと仮定します。この場合、重みの勾配は次のようになります。
$$
\frac{\partial L}{\partial w}=a
$$
たとえば、前の層の出力が \(a=-0.5\) と \(a=0.5\) だった場合、重みの勾配は次のようになります。
$$
\begin{aligned}
a=-0.5&\Rightarrow\frac{\partial L}{\partial w}=-0.5\\
a=0.5&\Rightarrow\frac{\partial L}{\partial w}=0.5
\end{aligned}
$$
一方、前の層の出力が常に正の値である場合、同じ条件では重みの勾配も正の値になります。
このように、前の層の出力が正負の値を持つと、次の層の重みの勾配にも正負の変化が生じる場合があります。その結果、条件によっては重みの更新方向の偏りが軽減され、学習を進めやすくなることがあります。
ただし、実際の勾配は \(\frac{\partial L}{\partial z}\) の符号や大きさにも依存します。tanh関数を使えば必ず勾配の符号が分散したり、学習が速くなったりするわけではありません。
5.3.具体例で重みの勾配を確認する
ここで、tanh関数を使ったニューロンの重みの勾配を計算してみましょう。前回と同じように、1つの入力を持つニューロンを考えます。
$$
z=wx+b,\quad y=\tanh(z)
$$
入力を \(x=1\)、重みを \(w=-1\)、バイアスを \(b=0\) とすると、次のようになります。
$$
\begin{aligned}
z&=wx+b=-1\\
y&=\tanh(-1)\approx-0.762
\end{aligned}
$$
正解を \(t=1\) とし、損失には二乗誤差を使います。
$$
L=\frac12(y-t)^2
$$
この損失を重み \(w\) で微分すると、連鎖律より、次のようになります。
$$
\frac{\partial L}{\partial w}
=
\frac{\partial L}{\partial y}
\frac{\partial y}{\partial z}
\frac{\partial z}{\partial w}
$$
ここで、それぞれの微分は次のようになります。
$$
\begin{aligned}
\frac{\partial L}{\partial y}&=y-t\\
\frac{\partial y}{\partial z}&=1-\tanh^2(z)\\
\frac{\partial z}{\partial w}&=x
\end{aligned}
$$
したがって、重みの勾配は次のように表せます。
$$
\frac{\partial L}{\partial w}
=
(y-t)(1-\tanh^2(z))x
$$
今回の値を代入して計算すると、次のようになります。
$$
\begin{aligned}
\frac{\partial L}{\partial w}
&\approx(-0.762-1)(1-(-0.762)^2)\times1\\
&\approx(-1.762)\times0.420\\
&\approx-0.740
\end{aligned}
$$
勾配降下法では、学習率を \(\eta\) とすると、重みを次のように更新します。
$$
w_{\mathrm{new}}
=
w-\eta\frac{\partial L}{\partial w}
$$
学習率を \(\eta=0.1\) とすると、更新後の重みは次のようになります。
$$
\begin{aligned}
w_{\mathrm{new}}
&\approx-1-0.1(-0.740)\\
&=-0.926
\end{aligned}
$$
つまり、tanh関数でも、導関数を使って重みの勾配を計算し、損失を小さくする方向へ重みを更新できます。
なお、前回のシグモイド関数の記事では、同じ入力と重みの条件で勾配が約 \(-0.144\) となりました。しかし、今回は活性化関数が異なるため、ニューロンの出力や損失も変わっています。そのため、勾配の絶対値が大きいことだけを理由に、tanh関数の方が学習性能に優れていると判断することはできません。
5.4.tanh関数でも勾配消失問題は起こる
tanh関数は、入力が \(0\) の付近では導関数が比較的大きくなります。しかし、入力の絶対値が大きくなると、出力は \(1\) または \(-1\) に近づきます。
このとき、導関数は次のようになります。
$$
\tanh'(x)=1-\tanh^2(x)\to0
$$
つまり、tanh関数も入力の絶対値が大きい領域では飽和し、導関数が \(0\) に近づきます。そのため、深いニューラルネットワークでは、誤差逆伝播法によって勾配を伝える際に値が小さくなり、前の層の重みが更新されにくくなる場合があります。
これは、シグモイド関数と同様に勾配消失問題につながる要因の1つです。tanh関数はシグモイド関数とは異なる利点を持ちますが、勾配消失問題を完全に解決する関数ではありません。
6.tanh関数は現在どのように使われているのか?
tanh関数は、ニューラルネットワークの中間層で使われてきた代表的な活性化関数です。
現在、一般的な深いフィードフォワードネットワークやCNNの中間層では、ReLUなどの活性化関数が広く使われています。一方、tanh関数も特定のモデルでは重要な役割を持っています。
たとえば、RNNやLSTMなどでは、隠れ状態や内部状態の候補を計算するときにtanh関数が使われます。tanh関数を使うと、計算結果を \(-1\) から \(1\) の範囲に変換できるため、正負の値を持つ情報を表現できます。
ただし、すべてのRNNやLSTMで同じ構成が使われるわけではなく、モデルの設計によって活性化関数の使い方は異なります。
まとめ
今回、見てきたことをまとめます。
- tanh関数は、入力を \(-1\) から \(1\) の範囲に滑らかに変換するS字型の関数である
- 入力が \(0\) のとき出力は \(0\) になり、グラフは原点対称になる
- tanh関数とシグモイド関数には、\(\tanh(x)=2\sigma(2x)-1\) という関係がある
- 出力が \(0\) を中心とする性質は、条件によっては学習に有利に働く
- 導関数は \(\tanh'(x)=1-\tanh^2(x)\) と表せ、最大値は \(1\) である
- 入力の絶対値が大きい領域では導関数が小さくなり、勾配消失問題につながる場合がある
- 現在もRNNやLSTMなどで利用されている
tanh関数は、入力を \(-1\) から \(1\) の範囲に変換し、正負の値を出力できる活性化関数です。シグモイド関数とは異なり出力が \(0\) を中心とする一方、入力が飽和領域に入ると勾配が小さくなるという限界もあります。
今回は、tanh関数の仕組みと、シグモイド関数との違いを確認しました。
次回は、入力が正のときにはそのまま出力し、負のときには \(0\) を出力するReLU関数について考えます。ReLU関数が深いニューラルネットワークで広く使われる理由を、微分と勾配の観点から理解していきます。
関連記事
シリーズ全体を理解する
(準備中)
関連書籍
ニューラルネットワークの活性化関数や学習の仕組みをさらに理解したい方には、次のような書籍もおすすめです。


コメント