はじめに
前回の記事では、tanh関数が入力を \(-1\) から \(1\) の範囲に変換する仕組みと、シグモイド関数との違いを確認しました。
tanh関数は、入力が \(0\) の付近では比較的大きな勾配を持ちます。しかし、入力の絶対値が大きくなると出力が \(1\) または \(-1\) に近づき、導関数が小さくなります。この性質は、深いニューラルネットワークで勾配消失問題が起こる要因の1つです。
では、入力が正の方向に大きくなっても、導関数が小さくならない活性化関数を使ったらどうでしょうか。
その代表的な関数が、ReLU関数(Rectified Linear Unit)です。
この記事では、ReLU関数がどのような計算を行うのかを理解し、計算のシンプルさと勾配の性質という2つの観点から、ニューラルネットワークの学習に適している理由を考えます。
この記事でわかること
この記事では、次の内容の理解を目指します。
- ReLU関数がどのような計算を行うのか
- シグモイド関数・tanh関数との違い
- ニューロンでReLU関数を使う計算例
- ReLU関数の微分と勾配の関係
- 計算のシンプルさがもたらす利点
- 正の領域で勾配が小さくなりにくい理由
- ReLU関数の特徴と限界
1.ReLU関数とは何か?
ReLU関数(Rectified Linear Unit)は、入力が正の場合にはその値をそのまま出力し、入力が負の場合には \(0\) を出力する活性化関数です。
次の式で定義されます。
$$
\mathrm{ReLU}(x)=\max(0,x)
$$
ここで、\(\max(0,x)\) は、\(0\) と \(x\) のうち大きい方を選ぶことを意味します。
場合分けして表すと、次のようになります。
$$
\mathrm{ReLU}(x)=
\begin{cases}
0 & (x\leq0)\\
x & (x>0)
\end{cases}
$$
つまり、ReLU関数は指数関数などを使わず、入力が正かどうかを確認するだけで出力を計算できます。
1.1.具体的な値を計算してみる
まず、入力が \(x=-2\) の場合を考えます。入力が負なので、ReLU関数の出力は \(0\) になります。
$$
\mathrm{ReLU}(-2)=0
$$
一方、入力が \(x=2\) の場合は、入力をそのまま出力します。
$$
\mathrm{ReLU}(2)=2
$$
入力が \(x=0\) の場合も、出力は \(0\) です。
$$
\mathrm{ReLU}(0)=0
$$
このように、ReLU関数は負の入力を \(0\) にし、正の入力はそのまま通すという、非常にシンプルな計算を行います。
1.2.ReLU関数のグラフ
ReLU関数をグラフにすると、次のようになります。
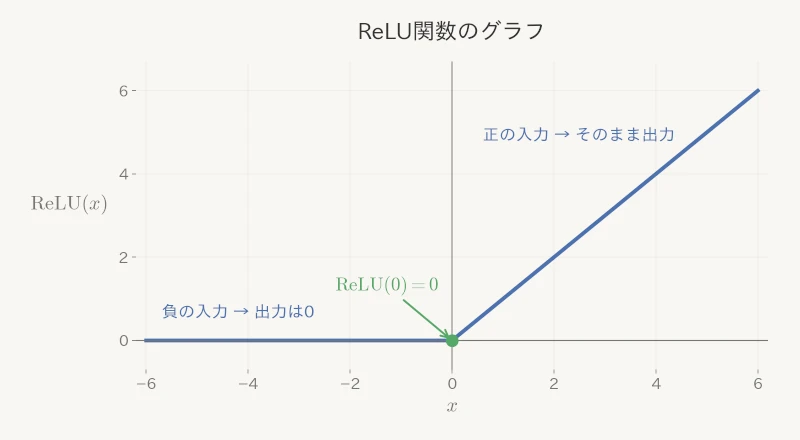
グラフを見ると、入力が \(0\) 以下の領域では出力が \(0\) のまま変化しません。一方、入力が正の領域では、入力が増えると出力も同じ割合で増加します。
シグモイド関数やtanh関数のような滑らかなS字型ではなく、原点で折れ曲がった形になることが特徴です。
2.シグモイド関数・tanh関数とは何が違うのか?
これまでに学んだシグモイド関数とtanh関数は、どちらも滑らかなS字型の関数でした。一方、ReLU関数は入力が正の領域では直線になり、負の領域では出力が \(0\) になります。
3つの関数をグラフで比較してみましょう。
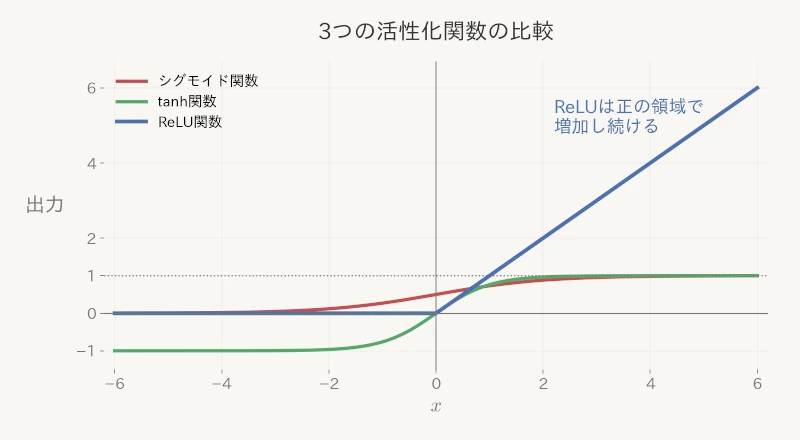
それぞれの特徴を整理すると、次のようになります。
| 特徴 | シグモイド | tanh | ReLU |
|---|---|---|---|
| 出力範囲 | \(0<\sigma(x)<1\) | \(-1<\tanh(x)<1\) | \(\mathrm{ReLU}(x)\geq0\) |
| 入力が \(0\) のとき | \(0.5\) | \(0\) | \(0\) |
| 負の入力に対する出力 | 正の値 | 負の値 | \(0\) |
| 正の入力が大きいとき | \(1\) に近づく | \(1\) に近づく | 入力とともに増加 |
特に重要なのは、ReLU関数には正の方向で出力が一定の値に近づく性質がないことです。
シグモイド関数やtanh関数では、入力が大きくなると出力の変化が小さくなります。一方、ReLU関数では、正の入力がどれだけ大きくなっても、出力は入力と同じ割合で増加します。
この違いは、後で確認する微分と勾配の性質につながります。
3.ReLU関数はニューロンでどのように使われるのか?
では、ReLU関数をニューロンに組み込むと、どのような計算になるのでしょうか。前回と同じように、2つの入力を受け取るニューロンを考えます。
入力を \(x_1,\ x_2\)、重みを \(w_1,\ w_2\)、バイアスを \(b\) とすると、活性化関数を適用する前の値は次のようになります。
$$
z=w_1x_1+w_2x_2+b
$$
ここにReLU関数を適用すると、ニューロンの出力 \(y\) は次のようになります。
$$
y=\mathrm{ReLU}(z)=\max(0,z)
$$
つまり、重み付き和とバイアスの計算結果が正であればそのまま出力し、負であれば \(0\) に変換します。
3.1.具体例で計算してみる
前回の記事と同じ条件で比較してみましょう。重みとバイアスを次のように設定します。
$$
w_1=1,\quad w_2=1,\quad b=-3
$$
このとき、ニューロンの計算は \(z=x_1+x_2-3\) となります。
まず、入力が \(x_1=2,\ x_2=2\) の場合を計算します。
$$
\begin{aligned}
z&=2+2-3=1\\
y&=\mathrm{ReLU}(1)=1
\end{aligned}
$$
一方、入力が \(x_1=1,\ x_2=1\) の場合は、次のようになります。
$$
\begin{aligned}
z&=1+1-3=-1\\
y&=\mathrm{ReLU}(-1)=0
\end{aligned}
$$
同じ重みとバイアスでも、入力によってニューロンの出力が変化します。ReLU関数では、重み付き和が正の場合には値がそのまま伝わり、負の場合には \(0\) になることがわかります。
4.ReLU関数を微分するとどうなるのか?
ここからは、ReLU関数を微分すると何がわかるのかを考えます。
前回のtanh関数では、導関数を求めるために指数関数や商の微分公式を使いました。一方、ReLU関数は場合分けされた簡単な式なので、微分も比較的シンプルです。
4.1.ReLU関数の導関数を求める
ReLU関数は、次のように定義されます。
$$
\mathrm{ReLU}(x)=
\begin{cases}
0 & (x\leq0)\\
x & (x \gt 0)
\end{cases}
$$
入力が負の場合、出力は常に \(0\) です。そのため、\(x \lt 0\) での導関数は \(0\) になります。
$$
\frac{d}{dx}0=0
$$
一方、入力が正の場合、出力は \(x\) なので、導関数は \(1\) になります。
$$
\frac{d}{dx}x=1
$$
したがって、ReLU関数の導関数は、\(x\neq0\) において次のようになります。
$$
\mathrm{ReLU}'(x)=
\begin{cases}
0 & (x\lt0)\\
1 & (x\gt0)
\end{cases}
$$
つまり、ReLU関数では、入力が正の領域で導関数が常に \(1\) になります。
4.2.入力が \(0\) のときは微分できるのか?
ここで注意したいのは、入力が \(x=0\) の場合です。
ReLU関数は原点で折れ曲がっているため、左側から近づいたときの傾きと、右側から近づいたときの傾きが異なります。
$$
\begin{aligned}
\text{左側の傾き}&=0\\
\text{右側の傾き}&=1
\end{aligned}
$$
そのため、ReLU関数は数学的には \(x=0\) で微分できません。
ただし、ニューラルネットワークの実装では、\(x=0\) の場合の勾配を便宜的に \(0\) などと定めて計算を行います。
このように扱うことで、ReLU関数は原点で微分できなくても、勾配を利用した学習に使用できます。
5.ReLU関数はなぜ学習に適しているのか?
ここまで、ReLU関数の計算と微分の特徴を確認しました。では、なぜReLU関数は深いニューラルネットワークで広く使われているのでしょうか。
ReLU関数には、大きく分けて2つの利点があります。
1つ目は、出力の計算が簡単であることです。2つ目は、正の領域で導関数が小さくならないことです。
この2つは異なる特徴なので、それぞれ分けて確認していきましょう。
5.1.計算が簡単であることの利点
シグモイド関数とtanh関数は、どちらも指数関数を使って定義されます。
$$
\sigma(x)=\frac{1}{1+e^{-x}}
$$
$$
\tanh(x)=\frac{e^x-e^{-x}}{e^x+e^{-x}}
$$
一方、ReLU関数は次の式で表せます。
$$
\mathrm{ReLU}(x)=\max(0,x)
$$
ReLU関数では、指数関数や除算を使う必要がありません。入力が正かどうかを判定し、正であればそのまま出力し、そうでなければ \(0\) を出力するだけです。
このため、ReLU関数の活性化処理は、シグモイド関数やtanh関数に比べて計算が単純です。
ニューラルネットワークでは、多数のニューロンに対して活性化関数を適用します。特に深いネットワークでは、この計算が何度も繰り返されるため、1回あたりの計算が簡単であることは、処理の効率を高めるうえで利点になります。
ただし、実際の実行時間はハードウェアや実装方法、行列演算などの処理にも左右されます。そのため、ReLU関数を使えばネットワーク全体の計算が必ず大幅に速くなるわけではありません。
また、ここで説明した計算の簡単さは、1回の活性化処理に必要な演算が少ないという意味です。次に説明する勾配の性質とは、分けて考える必要があります。
5.2.正の領域では勾配が小さくなりにくい
次に、ReLU関数のもう1つの利点である、微分と勾配の関係を考えます。
前回の記事では、tanh関数の導関数が次のようになることを確認しました。
$$
\tanh'(x)=1-\tanh^2(x)
$$
tanh関数では、入力の絶対値が大きくなると導関数が \(0\) に近づきます。また、シグモイド関数の導関数も、入力の絶対値が大きい領域では \(0\) に近づきます。
一方、ReLU関数の導関数は、入力が正の場合には常に \(1\) です。
$$
\mathrm{ReLU}'(x)=1\quad(x\gt0)
$$
3つの関数の導関数をグラフで比較してみましょう。
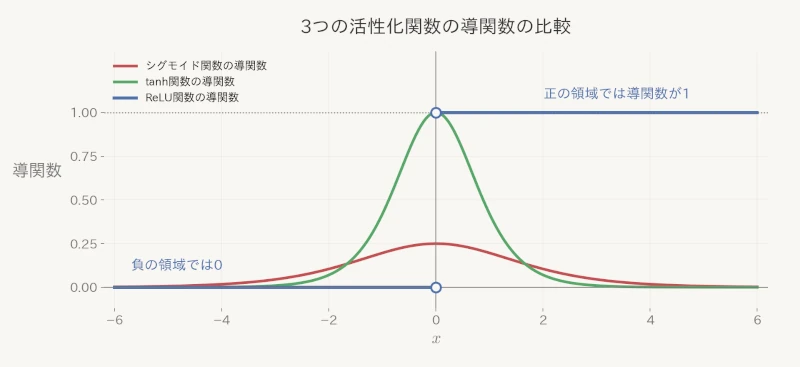
グラフから、シグモイド関数とtanh関数の導関数は入力の絶対値が大きくなると小さくなるのに対し、ReLU関数の導関数は正の領域で \(1\) を維持することがわかります。
ニューラルネットワークでは、誤差逆伝播法によって勾配を前の層へ伝えるときに、活性化関数の導関数を掛け合わせます。
たとえば、ある層に伝わってきた勾配を \(g\)、活性化関数を \(f\)、その入力を \(z\) とすると、活性化関数を通過した後の勾配は、次のように表せます。
$$
g_{\mathrm{new}}=g f'(z)
$$
ここで、\(g=0.8\) として、活性化関数の導関数が \(0.2\) の場合を考えると、次のようになります。
$$
g_{\mathrm{new}}=0.8\times0.2=0.16
$$
一方、ReLU関数の正の領域では導関数が \(1\) なので、次のようになります。
$$
g_{\mathrm{new}}=0.8\times1=0.8
$$
このように、ReLU関数の正の領域では、活性化関数の導関数によって勾配が縮小されません。
これは、深いニューラルネットワークで勾配を伝える際に重要な利点となります。
ただし、実際のニューラルネットワークでは、勾配は重み行列などの影響も受けます。そのため、ReLU関数を使えば勾配消失問題が必ず起こらなくなるわけではありません。
5.3.具体例で重みの勾配を確認する
ここで、ReLU関数を使ったニューロンの重みの勾配を計算してみましょう。前回と同じように、1つの入力を持つニューロンを考えます。
$$
z=wx+b,\quad y=\mathrm{ReLU}(z)
$$
まず、入力を \(x=1\)、重みを \(w=1\)、バイアスを \(b=0\) とします。このとき、次のようになります。
$$
\begin{aligned}
z&=1\times1+0=1\\
y&=\mathrm{ReLU}(1)=1
\end{aligned}
$$
正解を \(t=2\) とし、損失には二乗誤差を使います。
$$
L=\frac12(y-t)^2
$$
この損失を重み \(w\) で微分すると、連鎖律より、次のようになります。
$$
\frac{\partial L}{\partial w}
=
\frac{\partial L}{\partial y}
\frac{\partial y}{\partial z}
\frac{\partial z}{\partial w}
$$
それぞれの微分は、次のようになります。
$$
\begin{aligned}
\frac{\partial L}{\partial y}&=y-t\\
\frac{\partial y}{\partial z}&=\mathrm{ReLU}'(z)\\
\frac{\partial z}{\partial w}&=x
\end{aligned}
$$
したがって、重みの勾配は次のように表せます。
$$
\frac{\partial L}{\partial w}
=
(y-t)\mathrm{ReLU}'(z)x
$$
今回の例では \(z=1\gt0\) なので、\(\mathrm{ReLU}'(z)=1\) です。値を代入すると、次のようになります。
$$
\begin{aligned}
\frac{\partial L}{\partial w}
&=(1-2)\times1\times1\\
&=-1
\end{aligned}
$$
勾配降下法では、学習率を \(\eta\) とすると、重みを次のように更新します。
$$
w_{\mathrm{new}}
=
w-\eta\frac{\partial L}{\partial w}
$$
学習率を \(\eta=0.1\) とすると、更新後の重みは次のようになります。
$$
\begin{aligned}
w_{\mathrm{new}}
&=1-0.1(-1)\\
&=1.1
\end{aligned}
$$
このように、ReLU関数の入力が正の場合には、活性化関数の導関数が \(1\) になるため、勾配の計算に余分な縮小が入りません。
では、重みを更新することで、損失はどのように変化するのでしょうか。
更新前の出力は \(y=1\)、正解は \(t=2\) なので、損失は次のようになります。
$$
L_{\mathrm{before}}
=\frac12(1-2)^2
=0.5
$$
重みを \(w=1.1\) に更新すると、入力とバイアスは変わらないため、ニューロンの出力は次のようになります。
$$
\begin{aligned}
z&=1.1\times1+0=1.1\\
y&=\mathrm{ReLU}(1.1)=1.1
\end{aligned}
$$
したがって、更新後の損失は次のようになります。
$$
L_{\mathrm{after}}
=\frac12(1.1-2)^2
=0.405
$$
この例では、重みの更新によって損失が \(0.5\) から \(0.405\) に減少しました。ReLU関数の正の領域では、勾配を使って重みを更新し、予測を正解に近づけられることがわかります。
5.4.負の領域では勾配が \(0\) になる
一方、ReLU関数には注意すべき性質もあります。入力が負の場合には出力が \(0\) になり、導関数も \(0\) になります。
$$
\mathrm{ReLU}'(x)=0\quad(x\lt0)
$$
先ほどの例で、重みだけを \(w=-1\) に変更してみましょう。入力を \(x=1\)、バイアスを \(b=0\) とすると、次のようになります。
$$
\begin{aligned}
z&=-1\times1+0=-1\\
y&=\mathrm{ReLU}(-1)=0
\end{aligned}
$$
正解を先ほどと同じ \(t=2\) とすると、重みの勾配は次のようになります。
$$
\begin{aligned}
\frac{\partial L}{\partial w}
&=(y-t)\mathrm{ReLU}'(z)x\\
&=(0-2)\times0\times1\\
&=0
\end{aligned}
$$
この場合、予測と正解には差があるにもかかわらず、ReLU関数の導関数が \(0\) なので、この入力例からは重みを更新するための勾配が得られません。
勾配降下法では、勾配が \(0\) なので、重みを更新しても値は変化しません。つまり、予測と正解に差があっても、この入力からは学習が進まないことになります。
ただし、1つの入力例で勾配が \(0\) になっただけで、そのニューロンが常に学習できなくなるわけではありません。別の入力に対して重み付き和が正になれば、勾配が流れる可能性があります。
5.5.Dying ReLU問題とは何か?
ReLU関数を使うニューロンで、多くの入力に対して重み付き和が負になり続けると、出力が常に \(0\) になり、重みの更新が進まなくなる場合があります。
このような状態は、Dying ReLU問題と呼ばれます。
ReLU関数は、正の領域では勾配が小さくなりにくい一方、負の領域では勾配が完全に \(0\) になるという特徴があります。
この問題を軽減するために、負の入力に対しても小さな傾きを持たせたLeaky ReLUなどの関数が提案されています。Leaky ReLUについては、発展的な活性化関数を扱う記事で詳しく確認します。
6.ReLU関数は現在どのように使われているのか?
ReLU関数は、計算が簡単で、正の領域では勾配が小さくならないという特徴から、深いニューラルネットワークの中間層で広く使われてきました。
特に、画像認識に使われるCNNでは、畳み込み層の後などにReLU関数を適用する構成が代表的です。重み付き和による計算にReLU関数を組み合わせることで、ニューラルネットワークに非線形性を持たせることができます。
また、ReLU関数は負の入力を \(0\) にするため、出力の一部が \(0\) になることがあります。このように、多くのニューロンの出力が \(0\) になる状態を「疎な活性化」と呼びます。
ただし、すべてのニューラルネットワークでReLU関数が最適というわけではありません。モデルの構造や用途によっては、tanh関数やGELU、SiLUなど、別の活性化関数が選ばれることもあります。
まとめ
今回、見てきたことをまとめます。
- ReLU関数は、負の入力を \(0\) にし、正の入力をそのまま出力する活性化関数である
- ReLU関数は、\(\mathrm{ReLU}(x)=\max(0,x)\) というシンプルな式で表せる
- 指数関数や除算が不要なため、活性化処理の計算が比較的簡単である
- 正の領域では導関数が \(1\) となり、活性化関数によって勾配が小さくならない
- 入力が \(0\) の点では数学的に微分できないが、実装上は勾配を定めて学習できる
- 負の領域では導関数が \(0\) になり、重みが更新されない場合がある
- 多くの入力に対してニューロンが出力 \(0\) のままになるDying ReLU問題が起こることがある
- ReLU関数は、CNNなどの深いニューラルネットワークで広く使われている
ReLU関数は、計算がシンプルであることと、正の領域では勾配が小さくなりにくいことが大きな特徴です。一方、負の領域では勾配が \(0\) になるため、学習が進まなくなる場合もあります。
今回は、ReLU関数の仕組みと、シグモイド関数・tanh関数との違いを確認しました。
次回は、複数の出力を確率分布に変換するソフトマックス関数について考えます。ReLU関数が中間層でよく使われるのに対し、ソフトマックス関数は複数クラスの分類問題における出力層で重要な役割を持っています。
関連記事
(準備中)
シリーズ全体を理解する
(準備中)
関連書籍
ニューラルネットワークの活性化関数や学習の仕組みをさらに理解したい方には、次のような書籍もおすすめです。


コメント