はじめに
前回の記事では、ステップ関数の仕組みと、なぜ勾配を使ったニューラルネットワークの学習に向かないのかを確認しました。
ステップ関数は、入力に応じて出力を \(0\) か \(1\) に切り替える関数です。しかし、境界以外では微分すると \(0\) になり、境界では微分できないため、通常の勾配降下法による学習には適していません。
では、出力を突然切り替えるのではなく、入力に応じて滑らかに変化させたらどうでしょうか。
その考え方を実現する代表的な活性化関数が、シグモイド関数です。
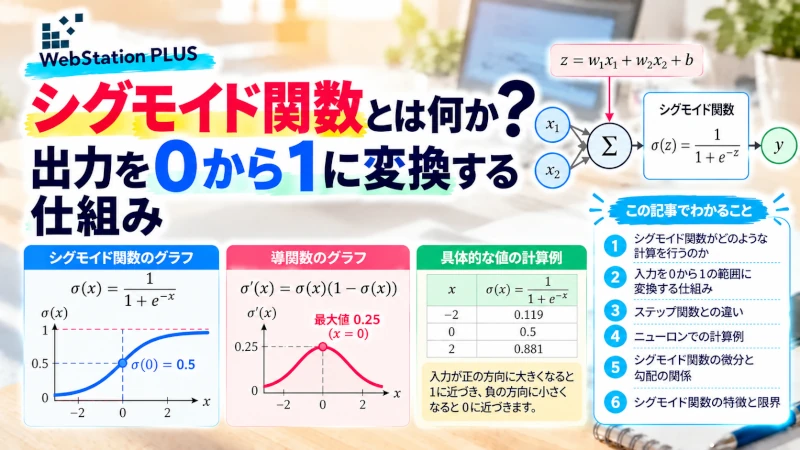
この記事では、シグモイド関数が入力を \(0\) から \(1\) の範囲に変換する仕組みを理解し、微分と勾配の観点から、ニューラルネットワークの学習でどのような役割を持つのかを考えます。
この記事でわかること
この記事では、次の内容の理解を目指します。
- シグモイド関数がどのような計算を行うのか
- 入力を \(0\) から \(1\) の範囲に変換する仕組み
- ステップ関数との違い
- ニューロンでシグモイド関数を使う計算例
- シグモイド関数の微分と勾配の関係
- シグモイド関数の特徴と限界
1.シグモイド関数とは何か?
シグモイド関数(sigmoid function)は、入力の値を滑らかに変換するS字型の関数です。ニューラルネットワークでは、一般に次のロジスティック関数をシグモイド関数と呼びます。
$$
\sigma(x)=\frac{1}{1+e^{-x}}
$$
ここで、\(e\) は自然対数の底と呼ばれる定数で、約 \(2.71828\) です。
この関数の特徴は、入力 \(x\) がどのような実数であっても、出力が必ず \(0\) より大きく、\(1\) より小さくなることです。
$$
0\lt\sigma(x)\lt1
$$
つまり、シグモイド関数は、負の値から正の値まで広がる入力を、\(0\) から \(1\) の間の値に変換します。
1.1.具体的な値を計算してみる
まず、入力が \(x=0\) の場合を考えます。
$$
\sigma(0)
=
\frac{1}{1+e^0}
=
\frac12
=
0.5
$$
次に、入力が \(x=2\) の場合は、次のようになります。
$$
\sigma(2)
=
\frac{1}{1+e^{-2}}
\approx0.881
$$
一方、入力が \(x=-2\) の場合は、次のようになります。
$$
\sigma(-2)
=
\frac{1}{1+e^2}
\approx0.119
$$
このように、入力が正の方向に大きくなると出力は \(1\) に近づき、負の方向に小さくなると出力は \(0\) に近づきます。ただし、入力が有限の値である限り、出力がちょうど \(0\) や \(1\) になることはありません。
1.2.シグモイド関数のグラフ
シグモイド関数をグラフにすると、次のようになります。
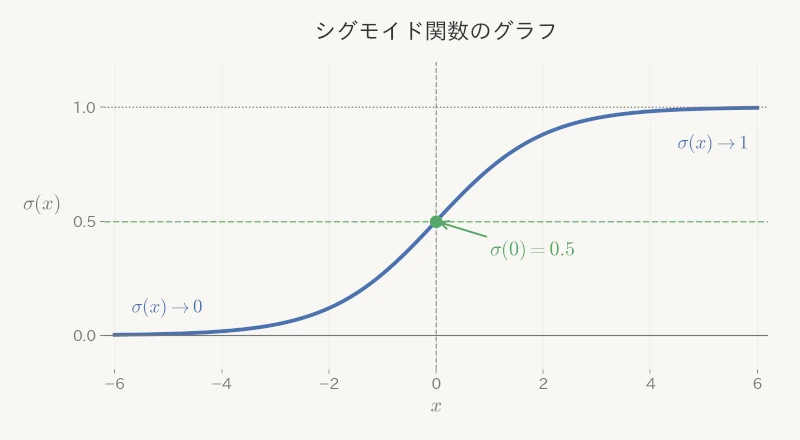
グラフを見ると、入力が \(x=0\) のとき出力は \(0.5\) になり、その周辺では入力の変化に応じて出力が大きく変化しています。
一方、入力が正の方向に大きくなると出力は \(1\) に、負の方向に小さくなると \(0\) に近づきます。
このように、シグモイド関数は入力を滑らかに変換するS字型の関数です。
2.ステップ関数とは何が違うのか?
前回の記事で扱ったステップ関数も、入力に応じて \(0\) か \(1\) の出力を決める関数でした。しかし、ステップ関数とシグモイド関数では、出力の変化の仕方が大きく異なります。
ステップ関数は、入力が境界をまたぐと出力が突然切り替わります。一方、シグモイド関数では、入力が変化すると出力も連続的に変化します。
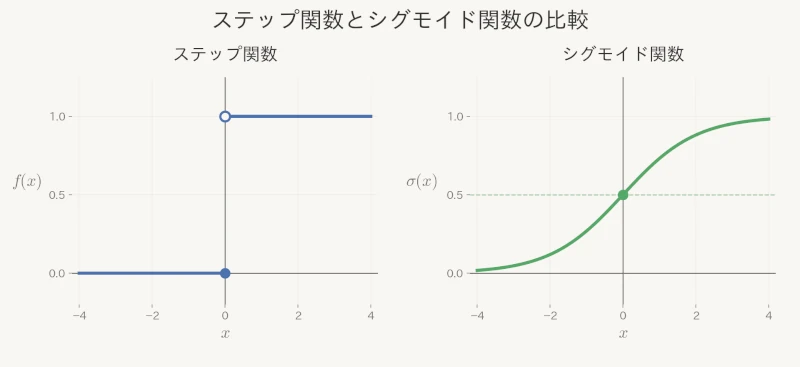
たとえば、入力が \(x=0\) の近くでわずかに変化した場合を考えます。
ステップ関数では、入力が境界をまたぐと出力が \(0\) から \(1\) へ突然切り替わります。しかし、シグモイド関数では、入力の変化に応じて出力も少しずつ変わります。
この違いは、ニューラルネットワークの学習を考えるうえで重要です。なぜなら、シグモイド関数は滑らかに変化するため、微分を使って出力の変化を調べられるからです。
3.シグモイド関数はニューロンでどのように使われるのか?
では、シグモイド関数をニューロンに組み込むと、どのような計算になるのでしょうか。
前回と同じように、2つの入力を受け取るニューロンを考えます。
入力を \(x_1,\ x_2\)、重みを \(w_1,\ w_2\)、バイアスを \(b\) とすると、活性化関数を適用する前の値は、次のようになります。
$$
z=w_1x_1+w_2x_2+b
$$
ここにシグモイド関数を適用すると、ニューロンの出力 \(y\) は次のようになります。
$$
y=\sigma(z)=\frac{1}{1+e^{-z}}
$$
ステップ関数の場合は、出力が \(0\) か \(1\) のどちらかでした。一方、シグモイド関数では、重み付き和とバイアスの計算結果に応じて、\(0\) から \(1\) の間の値を出力します。
3.1.具体例で計算してみる
たとえば、重みとバイアスを次のように設定します。
$$
w_1=1,\quad w_2=1,\quad b=-3
$$
このとき、ニューロンの計算は \(z=x_1+x_2-3\) となります。
まず、入力が \(x_1=2,\ x_2=2\) の場合、ニューロンの出力は次のようになります。
$$
\begin{aligned}
z&=2+2-3=1\\
y&=\sigma(1)=\frac{1}{1+e^{-1}}\approx0.731
\end{aligned}
$$
一方、入力が \(x_1=1,\ x_2=1\) の場合は、次のようになります。
$$
\begin{aligned}
z&=1+1-3=-1\\
y&=\sigma(-1)=\frac{1}{1+e^1}\approx0.269
\end{aligned}
$$
このように、シグモイド関数を使うと、ニューロンは入力に応じて連続的な値を出力できます。
なお、出力が \(0\) から \(1\) の範囲にあるからといって、必ずしも正解である確率を表しているわけではありません。二値分類などでは確率として解釈することがありますが、その意味はモデルの設計や学習方法によって決まります。
4.シグモイド関数を微分するとどうなるのか?
ここからは、シグモイド関数を微分すると何がわかるのかを考えます。
前回の記事では、ステップ関数は境界以外で微分すると \(0\) になり、通常の勾配降下法による学習に適していないことを確認しました。
では、シグモイド関数を微分すると、どのようになるのでしょうか。
4.1.シグモイド関数の導関数を求める
シグモイド関数は、次の式で定義されます。
$$
\sigma(x)=\frac{1}{1+e^{-x}}
$$
これを微分してみましょう。まず、分数を指数の形で表します。
$$
\sigma(x)=(1+e^{-x})^{-1}
$$
合成関数の微分である連鎖律を使うと、次のようになります。
$$
\begin{aligned}
\sigma'(x)
&=-(1+e^{-x})^{-2}(-e^{-x})\\
&=\frac{e^{-x}}{(1+e^{-x})^2}
\end{aligned}
$$
ここで、この式を少し変形します。
$$
\sigma'(x)
=
\frac{1}{1+e^{-x}}
\left(
1-\frac{1}{1+e^{-x}}
\right)
$$
シグモイド関数の定義を使うと、次のようになります。
$$
\sigma'(x)=\sigma(x)(1-\sigma(x))
$$
つまり、シグモイド関数の導関数は、シグモイド関数自身の出力を使って計算できるのです。この性質は、ニューラルネットワークの学習で勾配を計算するときにも役立ちます。
4.2.導関数の値を確認する
では、具体的な値を使って確認してみましょう。
入力が \(x=0\) のとき、\(\sigma(0)=0.5\) なので、
$$
\sigma'(0)
=
0.5(1-0.5)
=
0.25
$$
となります。
一方、入力が \(x=2\) のときは、\(\sigma(2)\approx0.881\) なので、
$$
\sigma'(2)
\approx
0.881(1-0.881)
\approx0.105
$$
となります。同様に、\(x=-2\) のときも、導関数の値は約 \(0.105\) です。
このように、シグモイド関数の導関数は、入力が \(0\) の付近で大きく、入力の絶対値が大きくなるほど小さくなります。また、導関数の最大値は \(x=0\) のときの \(0.25\) です。
5.なぜシグモイド関数は勾配を使った学習に利用できるのか?
ニューラルネットワークの学習では、損失を小さくするように、重みやバイアスを更新します。
前回の記事と同じように、1つの入力を持つニューロンを考えます。
$$
z=wx+b,\quad y=\sigma(z)
$$
損失を \(L\) とすると、連鎖律を使って、損失を重みで微分した値は次のように表せます。
$$
\frac{\partial L}{\partial w}
=
\frac{\partial L}{\partial y}
\frac{\partial y}{\partial z}
\frac{\partial z}{\partial w}
$$
ここで、\(\frac{\partial y}{\partial z}=\sigma'(z)\)、\(\frac{\partial z}{\partial w}=x\) なので、
$$
\frac{\partial L}{\partial w}
=
\frac{\partial L}{\partial y}
\sigma'(z)x
$$
となります。
ステップ関数では、境界以外で活性化関数の微分が \(0\) になりました。一方、シグモイド関数では、有限の入力に対して、
$$
\sigma'(z)=\sigma(z)(1-\sigma(z))\gt0
$$
です。
そのため、ステップ関数のように、境界以外のすべての点で活性化関数の微分が \(0\) になる問題を避けられます。
ただし、これは重みの勾配が必ず \(0\) 以外になるという意味ではありません。勾配は、入力 \(x\) や損失関数の微分にも依存します。
5.1.具体例で重みの更新を確認する
たとえば、入力を \(x=1\)、重みを \(w=-1\)、バイアスを \(b=0\) とします。このとき、ニューロンの出力は次のようになります。
$$
\begin{aligned}
z&=wx+b=-1\\
y&=\sigma(-1)\approx0.269
\end{aligned}
$$
正解を \(t=1\) とし、損失には二乗誤差を使います。
$$
L=\frac12(y-t)^2
$$
この損失を出力 \(y\) で微分すると、次のようになります。
$$
\frac{\partial L}{\partial y}=y-t
$$
また、シグモイド関数の導関数は、
$$
\sigma'(-1)
=
\sigma(-1)(1-\sigma(-1))
\approx0.197
$$
です。
したがって、重みの勾配は次のようになります。
$$
\begin{aligned}
\frac{\partial L}{\partial w}
&=(y-t)\sigma'(z)x\\
&\approx(0.269-1)\times0.197\times1\\
&\approx-0.144
\end{aligned}
$$
勾配降下法では、学習率を \(\eta\) とすると、重みを次のように更新します。
$$
w_{\mathrm{new}}
=
w-\eta\frac{\partial L}{\partial w}
$$
たとえば、学習率を \(\eta=0.1\) とすると、
$$
\begin{aligned}
w_{\mathrm{new}}
&\approx-1-0.1(-0.144)\\
&=-0.9856
\end{aligned}
$$
となります。
つまり、ステップ関数では更新できなかったこの例でも、シグモイド関数を使うことで、勾配に基づいて重みを更新できます。
なお、ここでは重みの更新だけを確認していますが、バイアスについても同様に勾配を計算できます。
6.シグモイド関数にも問題はあるのか?
ここまで見てきたように、シグモイド関数は滑らかに変化し、すべての実数で微分できます。
しかし、シグモイド関数を使えば、ニューラルネットワークの学習に関する問題がすべて解決するわけではありません。
6.1.入力の絶対値が大きいと勾配が小さくなる
シグモイド関数の導関数は、次の式で表されます。
$$
\sigma'(x)=\sigma(x)(1-\sigma(x))
$$
この導関数は、\(x=0\) のときに最大値 \(0.25\) を取ります。
一方、入力が正の方向に大きくなると、\(\sigma(x)\) は \(1\) に近づくため、\(1-\sigma(x)\) は \(0\) に近づきます。
また、入力が負の方向に小さくなると、\(\sigma(x)\) 自体が \(0\) に近づきます。
その結果、どちらの場合も導関数は \(0\) に近づきます。
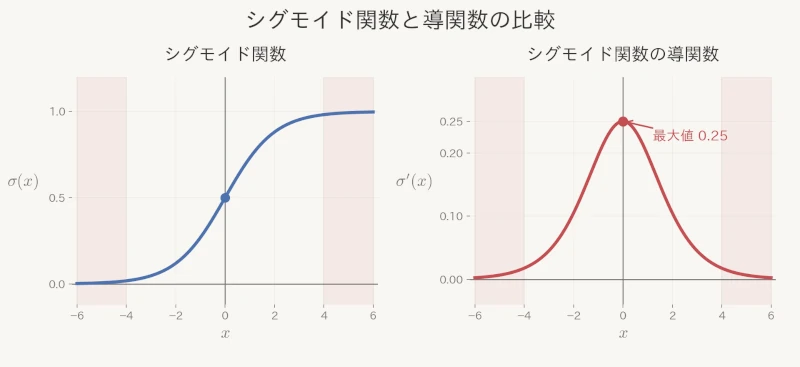
左側のグラフを見ると、入力の絶対値が大きい領域では、シグモイド関数の出力がほとんど変化していません。このような状態を飽和と呼びます。
右側のグラフでは、導関数が \(x=0\) で最大値 \(0.25\) を取り、入力の絶対値が大きくなるにつれて \(0\) に近づいています。
つまり、シグモイド関数は微分できるものの、飽和領域では勾配が非常に小さくなるのです。
6.2.勾配消失問題との関係
ニューラルネットワークでは、誤差逆伝播法を使って、各層の重みの勾配を計算します。この計算では、活性化関数の微分が関係します。
シグモイド関数の導関数は最大でも \(0.25\) であり、入力が飽和領域に入ると、さらに小さくなります。
そのため、深いニューラルネットワークでは、勾配を逆向きに伝える過程で値が小さくなり、前の層の重みが更新されにくくなる場合があります。
これが、勾配消失問題につながる要因の1つです。
ただし、ネットワーク全体の勾配は重み行列などにも依存するため、シグモイド関数を使うと必ず勾配が消失するわけではありません。
この問題は、後の「勾配消失問題」の記事で詳しく説明します。
7.シグモイド関数は現在どのように使われているのか?
シグモイド関数は、かつてニューラルネットワークの中間層でも広く使われていました。しかし、深いネットワークでは勾配消失問題が起こりやすいことなどから、現在は中間層の活性化関数としてReLUなどが広く使われています。
一方、シグモイド関数が使われなくなったわけではありません。
たとえば、二値分類では、出力層でシグモイド関数を使い、1つの値を \(0\) から \(1\) の範囲に変換することがあります。
また、LSTMなどのゲート機構でも、情報をどの程度通すかを調整するためにシグモイド関数が使われます。
つまり、シグモイド関数は、すべての層に適しているわけではありませんが、出力を \(0\) から \(1\) の範囲に変換したい場面では、現在も重要な役割を持つ関数です。
まとめ
今回、見てきたことをまとめます。
- シグモイド関数は、入力を \(0\) から \(1\) の範囲に滑らかに変換するS字型の関数である
- 入力が \(0\) のとき出力は \(0.5\) になり、入力の絶対値が大きくなると出力は \(0\) または \(1\) に近づく
- ステップ関数とは異なり、すべての実数で微分できる
- 導関数は \(\sigma'(x)=\sigma(x)(1-\sigma(x))\) と表せる
- 有限の入力では導関数が正になるため、勾配を利用した学習に使用できる
- ただし、入力が飽和領域に入ると導関数が小さくなり、勾配消失問題につながる場合がある
- 現在も二値分類の出力層やLSTMなどのゲート機構で利用されている
シグモイド関数は、入力を \(0\) から \(1\) の範囲に滑らかに変換し、微分を使って勾配を計算できる活性化関数です。ただし、入力の絶対値が大きい領域では勾配が小さくなるという限界もあります。
今回は、シグモイド関数の仕組みと、微分がニューラルネットワークの学習にどのように関係するのかを確認しました。
次回は、シグモイド関数と似たS字型の形状を持ちながら、出力が \(-1\) から \(1\) の範囲になるtanh関数について考えます。
関連記事
シリーズ全体を理解する
(準備中)
関連書籍
ニューラルネットワークの活性化関数や学習の仕組みをさらに理解したい方には、次のような書籍もおすすめです。


コメント